Việc định giá bất động sản xưa nay thường dựa trên kinh nghiệm chủ quan hoặc các phương pháp so sánh thủ công thiếu đi tính hệ thống. Tuy nhiên, sự bùng nổ của trí tuệ nhân tạo đã mang đến một bước ngoặt lớn, cho phép các nhà đầu tư và chuyên gia khai thác sức mạnh của công nghệ để dự báo giá trị tài sản với độ chính xác cao. Bài viết này sẽ hướng dẫn chi tiết cách xây dựng mô hình Machine Learning dự đoán giá nhà, từ khâu thu thập dữ liệu thô, xử lý tiền xử lý, lựa chọn thuật toán hồi quy cho đến bước tinh chỉnh tối ưu hóa nhằm mang lại hiệu quả thực tiễn tối ưu cho các dự án của bạn.
1. Tổng quan về bài toán dự đoán giá nhà trong khoa học dữ liệu
Bài toán định giá nhà là một trong những bài toán kinh điển thuộc lĩnh vực học máy có giám sát (Supervised Learning). Hiểu được bản chất của bài toán này là bước đệm quan trọng trước khi đi sâu vào các bước triển khai kỹ thuật phức tạp.
1.1. Bản chất toán học của mô hình hồi quy giá nhà
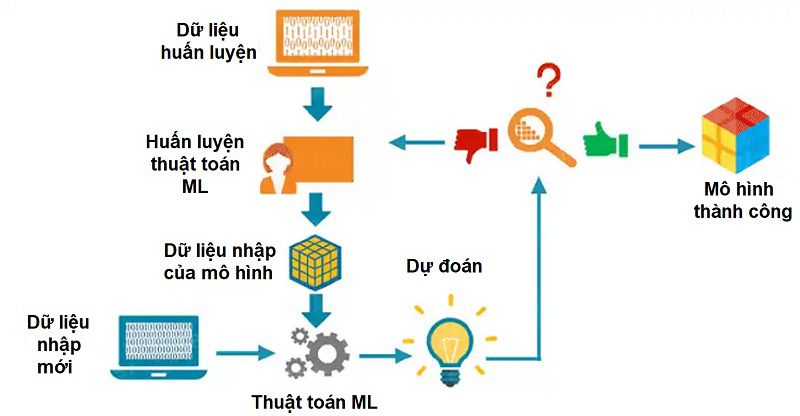
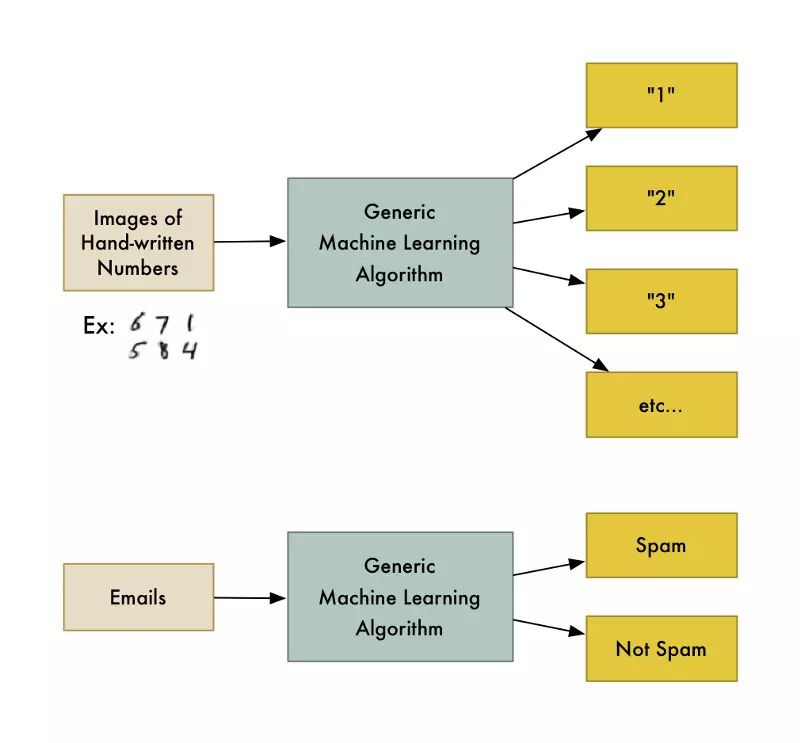
Trong Machine Learning, giá nhà là một biến liên tục, do đó bài toán được giải quyết thông qua các thuật toán Hồi quy (Regression). Mô hình sẽ tìm kiếm mối quan hệ toán học giữa biến mục tiêu (Label – giá nhà) và các biến đặc trưng (Features – diện tích, số phòng, vị trí, năm xây dựng…).
- Biến đầu vào (X): Tập hợp các đặc trưng vật lý và vị trí địa lý của bất động sản.
- Biến đầu ra (y): Giá trị dự đoán bằng tiền của căn nhà đó trên thị trường.
1.2. Xác định mục tiêu và đối tượng ứng dụng thực tế
Việc áp dụng công nghệ không chỉ dành riêng cho các kỹ sư dữ liệu lớn mà còn phục vụ đắc lực cho các sàn giao dịch bất động sản, ngân hàng thẩm định tín dụng hay các nhà đầu tư cá nhân. Một hệ thống định giá chuẩn xác giúp giảm thiểu rủi ro tài chính, rút ngắn thời gian định giá và tăng tính minh bạch cho thị trường. Để nắm vững toàn bộ quy trình chuyên sâu này, bạn có thể tham khảo thêm các tài liệu chất lượng tại mpacademy.edu.vn.
2. Quy trình thu thập và tiền xử lý dữ liệu bất động sản
Dữ liệu chính là nguyên liệu cốt lõi quyết định sự thành bại của bất kỳ thuật toán học máy nào. Một tập dữ liệu sạch, phong phú sẽ giúp thuật toán học hỏi hiệu quả hơn.
2.1. Thu thập dữ liệu từ các nguồn uy tín
Quá trình thu thập đòi hỏi việc tổng hợp thông tin từ nhiều nguồn khác nhau bao gồm:
- Các trang web rao vặt bất động sản lớn thông qua công cụ cào dữ liệu (Web Scraping).
- Cơ sở dữ liệu lịch sử giao dịch từ các cơ quan quản lý nhà đất địa phương.
- Dữ liệu không gian địa lý (GIS) để tính toán khoảng cách đến các tiện ích công cộng như trường học, bệnh viện, trung tâm thương mại.
2.2. Xử lý dữ liệu nhiễu và điền giá trị thiếu (Missing Values)
Dữ liệu thô thường chứa rất nhiều điểm bất thường (outliers) như giá nhà ghi nhầm, diện tích không hợp lý hoặc các ô trống thông tin.
- Loại bỏ nhiễu: Sử dụng các phương pháp thống kê như khoản tứ phân vị (IQR) để phát hiện và xử lý các căn nhà có mức giá bất thường so với khu vực xung quanh.
- Điền dữ liệu thiếu: Thay thế các giá trị bị thiếu bằng giá trị trung bình (Mean), trung vị (Median) hoặc sử dụng các thuật toán nội suy nâng cao.
2.3. Chuẩn hóa và mã hóa biến phân loại (Encoding & Scaling)
Các thuật toán học máy yêu cầu dữ liệu đầu vào phải ở dạng số. Do đó, các biến phân loại như hướng nhà, loại hình bất động sản cần được chuyển đổi thông qua kỹ thuật One-Hot Encoding hoặc Label Encoding. Đồng thời, việc chuẩn hóa khoảng giá trị (Feature Scaling) giúp các thuật toán dựa trên khoảng cách hoạt động ổn định hơn.
3. Lựa chọn đặc trưng và kỹ thuật xây dựng Feature Engineering
Feature Engineering (Kỹ thuật đặc trưng) được xem là nghệ thuật trong khoa học dữ liệu, giúp chuyển đổi dữ liệu thô thành những thông tin có ý nghĩa cao đối với mô hình.
3.1. Tạo mới các đặc trưng thông minh từ dữ liệu cũ
Thay vì chỉ sử dụng các cột dữ liệu nguyên bản, việc kết hợp chúng lại tạo ra góc nhìn sắc sảo hơn cho mô hình:
- Diện tích sử dụng trên mỗi phòng: Phản ánh độ rộng rãi thực tế của không gian sống.
- Tuổi thọ ngôi nhà: Được tính bằng năm hiện tại trừ đi năm xây dựng hoặc năm cải tạo gần nhất.
- Mật độ tiện ích xung quanh: Số lượng trường học, chợ, siêu thị bán kính trong vòng 1-2 km.
3.2. Phân tích tương quan và lựa chọn đặc trưng tối ưu
Không phải mọi đặc trưng đều mang lại giá trị tích cực; một số có thể gây ra hiện tượng đa cộng tuyến (Multicollinearity). Sử dụng ma trận tương quan Pearson hoặc phương pháp Recursive Feature Elimination (RFE) giúp lọc ra các biến thực sự quan trọng, loại bỏ các biến nhiễu làm giảm hiệu suất dự báo của hệ thống.
4. Huấn luyện và đánh giá các thuật toán Machine Learning
Sau khi hoàn thiện bước chuẩn bị dữ liệu, giai đoạn cốt lõi là đưa dữ liệu vào các mô hình học máy để huấn luyện và tìm ra cấu trúc phù hợp nhất.
4.1. Các thuật toán hồi quy phổ biến
- Linear Regression (Hồi quy tuyến tính): Thuật toán cơ bản, dễ hiểu, phù hợp khi mối quan hệ giữa biến đầu vào và giá nhà mang tính tuyến tính rõ rệt.
- Decision Trees và Random Forest: Các thuật toán dạng cây quyết định, có khả năng xử lý tốt các mối quan hệphi tuyến tính phức tạp và các biến phân loại mà ít bị ảnh hưởng bởi dữ liệu ngoại lai.
- Gradient Boosting (XGBoost, LightGBM): Nhóm thuật toán tối ưu hóa mạnh mẽ, thường xuyên giành chiến thắng trong các cuộc thi khoa học dữ liệu nhờ tốc độ xử lý nhanh và độ chính xác vượt trội.
4.2. Phương pháp đánh giá hiệu suất mô hình
Để biết mô hình dự đoán chính xác đến mức nào, các chỉ số đánh giá tiêu chuẩn cần được áp dụng trên tập dữ liệu kiểm thử (Test Set):
- MAE (Mean Absolute Error): Sai số tuyệt đối trung bình, dễ diễn giải theo đơn vị tiền tệ thực tế.
- MSE / RMSE (Root Mean Squared Error): Phạt nặng các lỗi dự đoán lớn, giúp kiểm soát các trường hợp sai lệch nghiêm trọng.
- R-squared (R2 Score): Đo lường mức độ biến thiên của giá nhà được giải thích bởi các đặc trưng trong mô hình.
Bài viết đã cung cấp toàn diện cách xây dựng mô hình Machine Learning dự đoán giá nhà từ lý thuyết nền tảng đến kỹ thuật thực chiến chuyên sâu. Việc áp dụng đúng quy trình thu thập, xử lý dữ liệu và tối ưu hóa thuật toán sẽ giúp bạn tạo ra một hệ thống dự báo tài sản cực kỳ mạnh mẽ và chuẩn xác.
